Domain tropomyosin.de kaufen?
Wir ziehen mit dem Projekt
tropomyosin.de um.
Sind Sie am Kauf der Domain
tropomyosin.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain tropomyosin.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
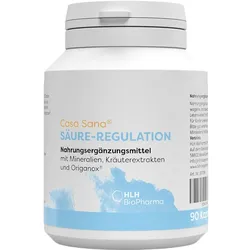
Casa Sana SÄURE-REGULATION KapselnAnwendungsgebiet von Casa Sana SÄURE-REGULATION Kapseln Casa Sana SÄURE-REGULATION – Detox & Stärkung des Bindegewebes Casa Sana SÄURE-REGULATION Kapseln enthält neben einer besonders wirksamen Mineralstoffmischung vier Kräuterextrakte und als Verstärker dieser Grundsubstanzen das Antioxidans ORIGANOX. Carbonate und Citrate bauen Säuren und Schadstoffe im Bindegewebe ab. Dabei wird nicht nur die momentan durch die Nahrungsaufnahme auftretende Übersäuerung abgepuffert, sondern die abgelagerten Säuremoleküle werden gelöst und abtransportiert. Zu Detox und einer Entsäuerung bieten natürliche Stoffe eine sinnvolle Alternative. Wirkungsweise von Casa Sana SÄURE-REGULATION KapselnCasa Sana SÄURE-REGULATION Kapseln enthält Carbonate und Citrate, sowie vier verschiedene Mineralien. Zusätzlich sind Extrakte aus den Pflanzen Rosmarin, Thymian, Salbei und Fenchel enthalten. Abgerundet wird die außergewöhnliche Rezeptur durch Origanox, einem speziellen Extrakt aus dem wilden Majoran.Wirkstoffe / Inhaltsstoffe / ZutatenZutaten von Casa Sana SÄURE-REGULATION Kapseln: Natriumhydrogencarbonat, Origanox (Extrakt aus wildem Majoran) 20 %, Hydroxypropylmethylcellulose (Kapselhülle), Calciumcitrat, Magnesiumcitrat, Kaliumhydrogencarbonat, Füllstoff: Cellulosepulver, Rosmarinextrakt, Thymianextrakt, Salbeiextrakt, Fenchelextrakt, Trennmittel: Calciumphosphat, Verdickungsmittel: Gellan GegenanzeigenBei bekannter Überempfindlichkeit gegenüber einen der oben genannten Inhaltsstoffe sollte dieses Produkt nicht angewendet werden.DosierungVerzehrempfehlung von Casa Sana SÄURE-REGULATION Kapseln: 3 x täglich 2 magensaftresistente Kapseln zwischen den Mahlzeiten mit einem Glas Wasser einnehmen. SchwangerschaftDas Präparat sollte während der Schwangerschaft und Stillzeit nicht verwendet werden.Personen mit bekannten Unverträglichkeiten gegenüber einem der Inhaltsstoffe sollten auf die Einnahme verzicht18,28 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
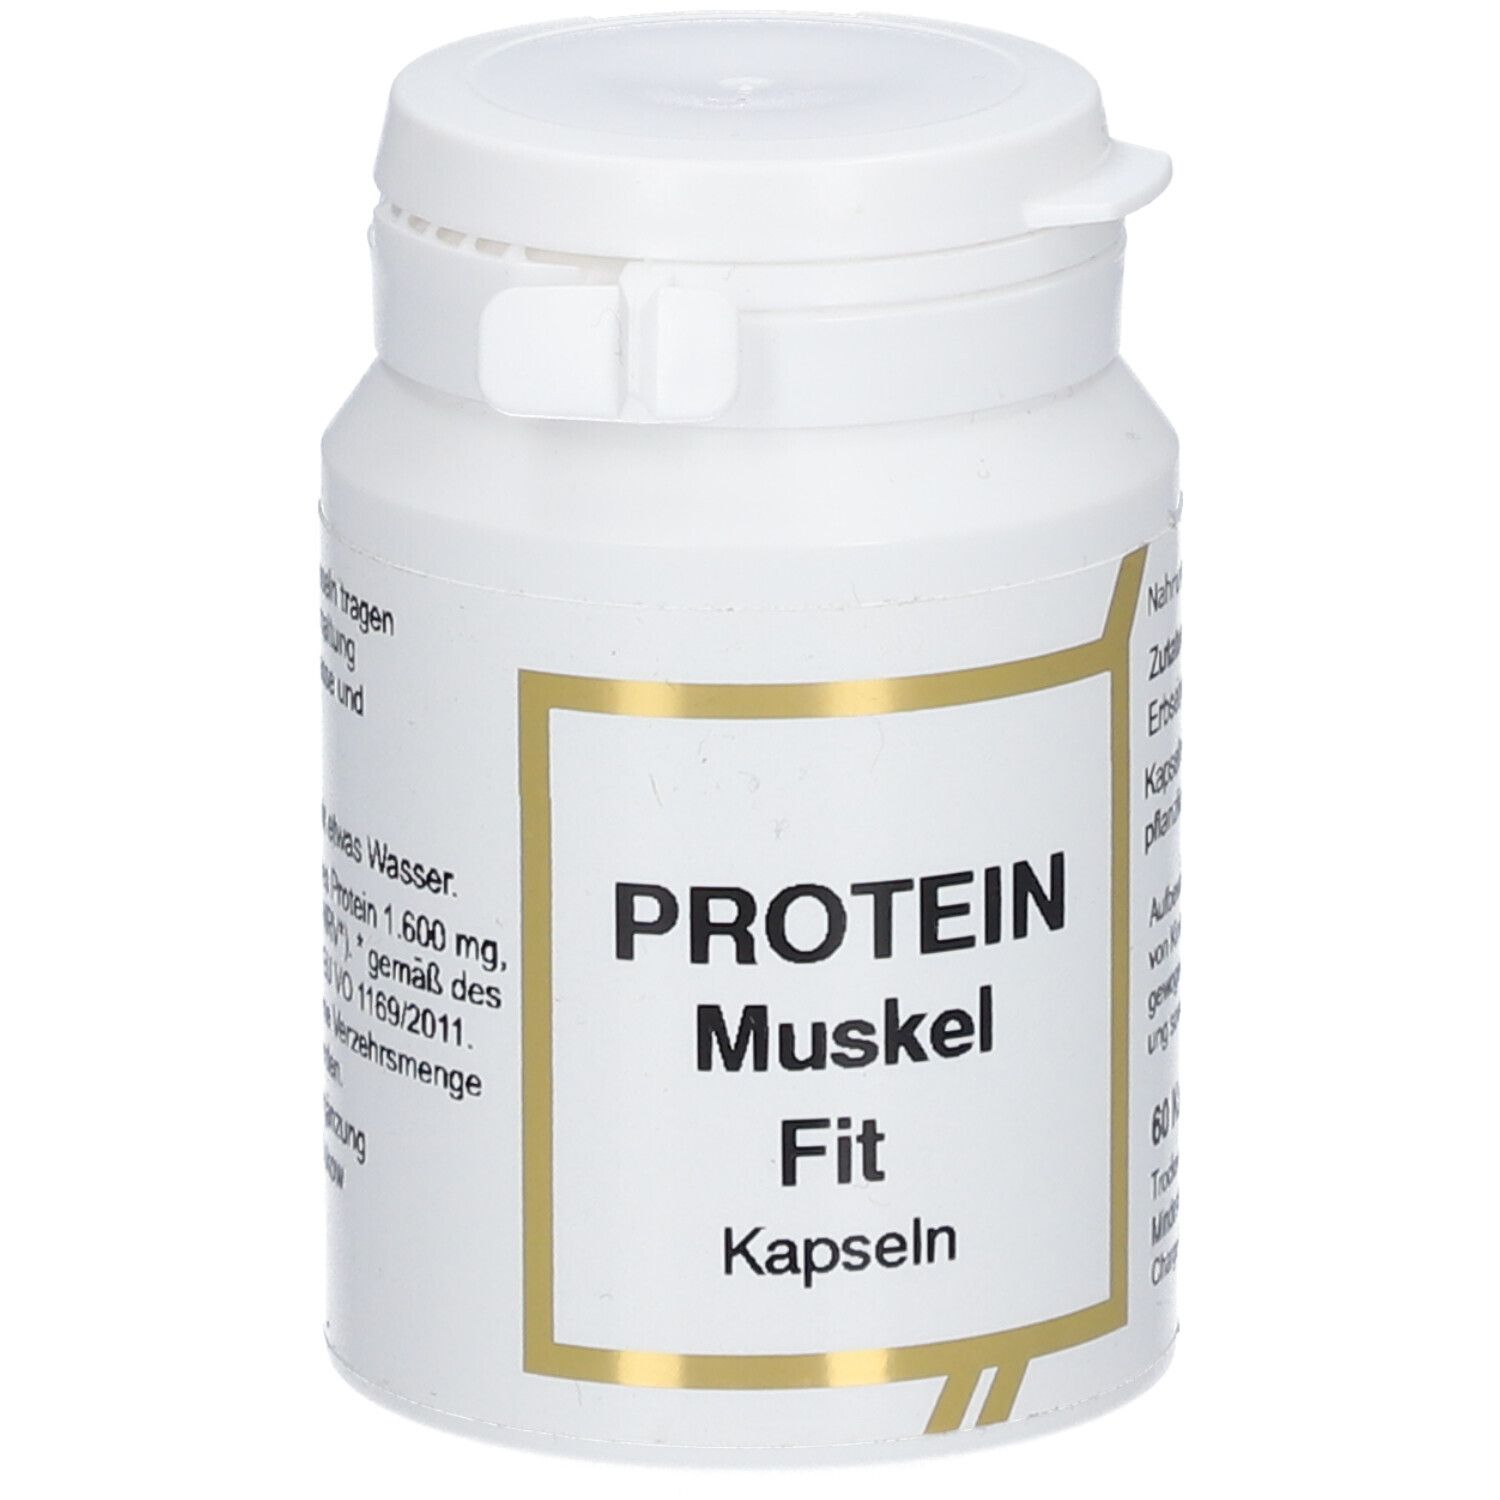
Protein Muskel FIT KPS 60 St KapselnNahrungsergänzungsmittel sind kein Ersatz für eine ausgewogene und abwechslungsreiche Ernährung und eine gesunde Lebensweise.Protein Muskel Fit Kapseln tragen bei mit Magensium zur Erhaltung einer normalen Muskelmasse und Muskelfunktion.Zutaten: pro Kapsel: Erbsenprotein Pulver, Magnesiumcitrat Kapselhülle: Hydroxypropylmethylcellulose pflanzlich Nährwerte: Tagesdosis: 100 % veganes Protein 1.600 mg, Magnesium 120 mg (32% NRV*) * gemäß des Nährstoffbezugswerts der EU VO 1169/2011 Verzehrempfehlung: Täglich 2 bis 4 Kapseln mit etwas Wasser Hinweis:Die angegebene empfohlene Tagesmenge darf nicht überschritten werden.Aufbewahrung: Kühl (6-25 °C) und lichtgeschützt lagern. Außerhalb der Reichweite von Kindern aufbewahren. Nettofüllmenge: 60 Kapseln 43,2 g Hersteller: GRÜNTUN Kirchweg 7c 18233 Alt Bukow21,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
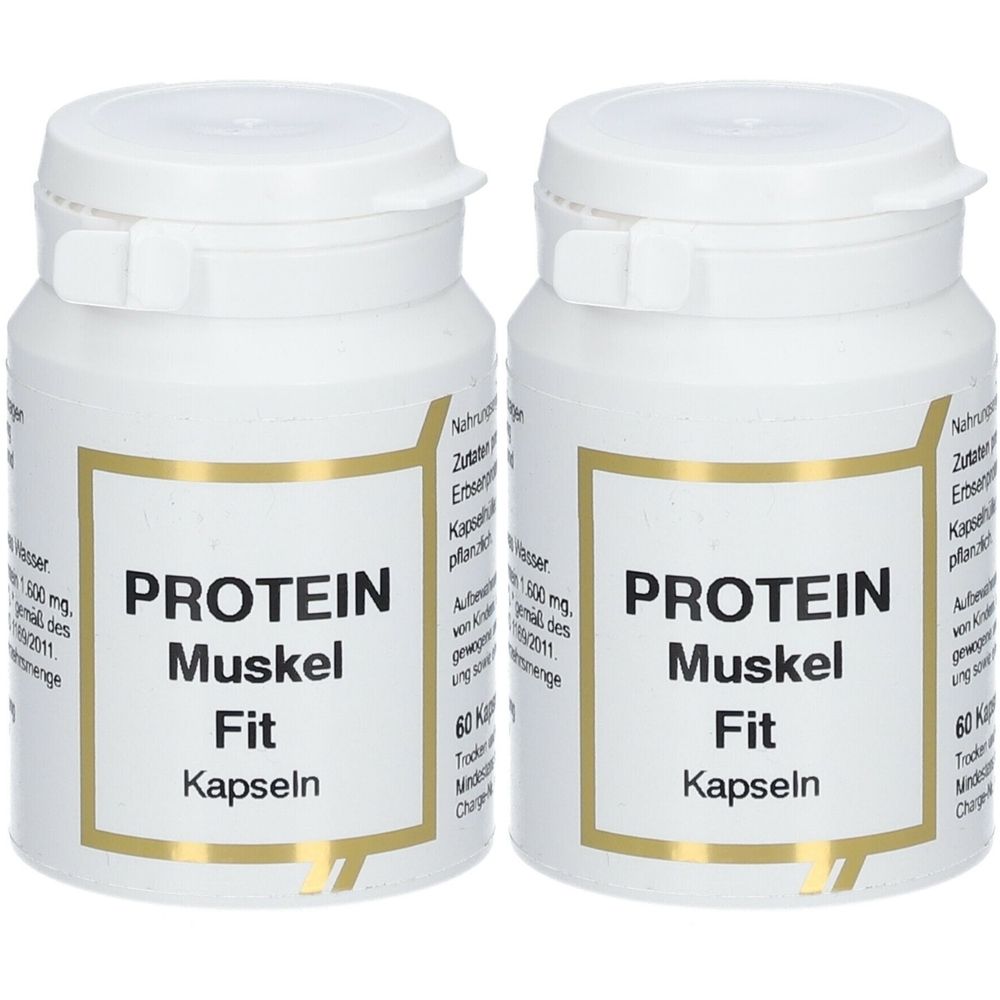
Protein Muskel FIT KPS x2 2x60 St KapselnBitte achten Sie auf eine ausgewogene und abwechslungsreiche Ernährung und eine gesunde Lebensweise.Set enthält2x Protein Muskel Fit 60 StNahrungsergänzungsmittel sind kein Ersatz für eine ausgewogene und abwechslungsreiche Ernährung und eine gesunde Lebensweise.Protein Muskel Fit Kapseln tragen bei mit Magensium zur Erhaltung einer normalen Muskelmasse und Muskelfunktion.Zutaten: pro Kapsel: Erbsenprotein Pulver, Magnesiumcitrat Kapselhülle: Hydroxypropylmethylcellulose pflanzlich Nährwerte: Tagesdosis: 100 % veganes Protein 1.600 mg, Magnesium 120 mg (32% NRV*) * gemäß des Nährstoffbezugswerts der EU VO 1169/2011 Verzehrempfehlung: Täglich 2 bis 4 Kapseln mit etwas Wasser Hinweis:Die angegebene empfohlene Tagesmenge darf nicht überschritten werden.Aufbewahrung: Kühl (6-25 °C) und lichtgeschützt lagern. Außerhalb der Reichweite von Kindern aufbewahren. Nettofüllmenge: 60 Kapseln 43,2 g Hersteller: GRÜNTUN Kirchweg 7c 18233 Alt Bukow41,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Casa Sana SÄURE-REGULATION KapselnAnwendungsgebiet von Casa Sana SÄURE-REGULATION Kapseln Casa Sana SÄURE-REGULATION – Detox & Stärkung des Bindegewebes Casa Sana SÄURE-REGULATION Kapseln enthält neben einer besonders wirksamen Mineralstoffmischung vier Kräuterextrakte und als Verstärker dieser Grundsubstanzen das Antioxidans ORIGANOX. Carbonate und Citrate bauen Säuren und Schadstoffe im Bindegewebe ab. Dabei wird nicht nur die momentan durch die Nahrungsaufnahme auftretende Übersäuerung abgepuffert, sondern die abgelagerten Säuremoleküle werden gelöst und abtransportiert. Zu Detox und einer Entsäuerung bieten natürliche Stoffe eine sinnvolle Alternative. Wirkungsweise von Casa Sana SÄURE-REGULATION KapselnCasa Sana SÄURE-REGULATION Kapseln enthält Carbonate und Citrate, sowie vier verschiedene Mineralien. Zusätzlich sind Extrakte aus den Pflanzen Rosmarin, Thymian, Salbei und Fenchel enthalten. Abgerundet wird die außergewöhnliche Rezeptur durch Origanox, einem speziellen Extrakt aus dem wilden Majoran.Wirkstoffe / Inhaltsstoffe / ZutatenZutaten von Casa Sana SÄURE-REGULATION Kapseln: Natriumhydrogencarbonat, Origanox (Extrakt aus wildem Majoran) 20 %, Hydroxypropylmethylcellulose (Kapselhülle), Calciumcitrat, Magnesiumcitrat, Kaliumhydrogencarbonat, Füllstoff: Cellulosepulver, Rosmarinextrakt, Thymianextrakt, Salbeiextrakt, Fenchelextrakt, Trennmittel: Calciumphosphat, Verdickungsmittel: Gellan GegenanzeigenBei bekannter Überempfindlichkeit gegenüber einen der oben genannten Inhaltsstoffe sollte dieses Produkt nicht angewendet werden.DosierungVerzehrempfehlung von Casa Sana SÄURE-REGULATION Kapseln: 3 x täglich 2 magensaftresistente Kapseln zwischen den Mahlzeiten mit einem Glas Wasser einnehmen. SchwangerschaftDas Präparat sollte während der Schwangerschaft und Stillzeit nicht verwendet werden.Personen mit bekannten Unverträglichkeiten gegenüber einem der Inhaltsstoffe sollten auf die Einnahme verzicht18,28 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Casa Sana Säure-Regulation 90 STProdukteigenschaften: Bezeichnung: Nahrungsergänzungsmittel mit Carbonaten, Citraten und ausgewählten Kräuterextrakten Verwendung/Anwendung/Verzehrempfehlung: 3 x täglich 1 - 2 Kapseln zwischen den Mahlzeiten mit einem Glas Wasser einnehmen. 6 Kapseln enthalten 600 mg Origanox®. Zutaten: Natriumhydrogencarbonat, Origanox® (Extrakt aus wildem Majoran), Gelatine (Kapselhülle), Tri-Magnesiumdicitrat, Tri-Calciumcitrat, Trennmittel: Kaliumhydrogencarbonat, Rosmarinextrakt, Thymianextrakt, Salbeiextrakt, Fenchelextrakt, Wasser, Trennmittel: Magnesiumsalze der Speisefettsäuren, Calciumphosphat Füllstoff: Mikrokristalline Cellulose, Farbstoff: Titandioxid Nettofüllmenge: 54 g Aufbewahrungsbedingungen: Gut verschlossen und trocken lagern. Muss nicht in den Kühlschrank! Ursprungsland des Lebensmittels: Deutschland Anschrift des Herstellers: HLH Bio Pharma Vertriebs GmbH Auf dem Steinocken 5 58802 Balve - Enthält Carbonate und Citrate - Enthält Origanox®, ein Extrakt aus dem wilden Majoran - Enthält Kräuterextrakte aus Rosmarin, Thymian, Salbei und Fenchel Enthält ausgewählte Kräuter und Mineralien in Kombination mit dem speziellen Origanox® -Extrakt. Altersstufe: Casa Sana® SÄURE-REGULATION ist geeignet für alle Personen ab 8 Jahren. Casa Sana® SÄURE-REGULATION ist frei von Hefe, Laktose, Gluten, Bindemitteln, Farbstoffen, künstlichen Aromen und Gentechnik. Hinweise: Die empfohlene tägliche Verzehrmenge sollte nicht überschritten werden. Außerhalb der Reichweite von kleinen Kindern lagern. Nahrungsergänzungsmittel sind kein Ersatz für eine ausgewogene und abwechslungsreiche Ernährung. Bis zu zwei Jahre haltbar! Bietet sich wegen der rein biologischen Zusammensetzung zum ständigen Verzehr an. Geeignet für Verbraucher die Milchprodukte nicht mögen oder vertragen. Für Diabetiker und Nahrungsmittel-Allergiker geeignet. Quelle: Angaben der Verpackung Stand: 08/201617,23 €*Versand: 4,50 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.